Durante l’evento Microsoft Ignite 2023, è stato presentato al mondo Azure AI Speech text to speech avatar, uno strumento capace di generare video di un avatar partendo dalle immagini fornite dall’utente ed in grado di pronunciare frasi ed interi discorsi scritti sempre dall’utente stesso. Lo strumento di Microsoft si basa su due componenti distinte: un modello per gestire l’avatar e uno strumento di sintesi vocale per “leggere” il testo inoltrato dall’utente.
Cos’è un deepfake?
“Perché fa tanto scalpore una notizia del genere?” Immagino che sia questa la domanda che vi stiate ponendo ed io sono qui per spiegarvelo.
Un deepfake è una forma avanzata di manipolazione multimediale che utilizza algoritmi di apprendimento automatico per sostituire volti o voci in video e immagini. Questa tecnologia può creare contenuti apparentemente autentici, spesso utilizzata per scopi ingannevoli come falsificare discorsi o scene in modo realistico. L’aumento della potenza computazionale e delle capacità di apprendimento automatico ha reso i deepfake sempre più sofisticati, sollevando preoccupazioni riguardo alla diffusione di informazioni false e alla minaccia alla credibilità visiva e uditiva.
Da quanto detto, con strumenti IA sempre più potenti ed avanzati, potete capire quanto sia semplice creare falsi talmente convincenti che, se usati per scopi poco leciti, possono avere gravi conseguenze
Come funziona questo nuovo modello di Microsoft?
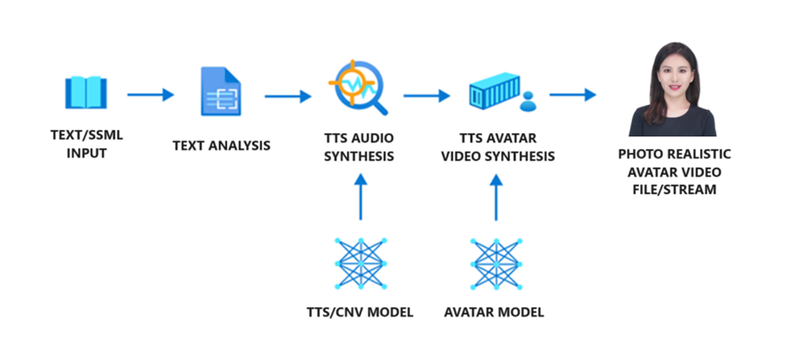
Come spiega Microsoft in un post sul suo blog “Con l’avatar di sintesi vocale, gli utenti possono creare video in modo più efficiente… per creare video di formazione, presentazioni di prodotti, testimonianze di clienti [e così via] semplicemente con l’immissione di testo”. “Si può utilizzare l’avatar per creare agenti conversazionali, assistenti virtuali, chatbot e altro ancora.”
Nel video di presentazione della nuova tecnologia, Microsoft ha introdotto avatar generati attraverso Azure Text to Speech, creando non solo l’aspetto visivo ma anche la voce della persona rappresentata. Questi avatars hanno la capacità di comunicare in diverse lingue e di utilizzare modelli di intelligenza artificiale avanzati, come il GPT-3.5 di OpenAI, per rispondere alle domande degli utenti. Al lancio, la maggior parte degli abbonati di Azure avrà accesso solo a avatar pre-costruiti, non personalizzati. Al contrario, gli avatar personalizzati sono attualmente disponibili solo attraverso una registrazione con “accesso limitato” per specifici casi d’uso, secondo quanto dichiarato da Microsoft.
Il servizio vocale neurale personalizzato di Microsoft include anche lo strumento Personal Voice, che consente di replicare la voce di un utente in pochi secondi fornendo un campione vocale di un minuto. Questa funzionalità può essere utilizzata per creare assistenti vocali personalizzati, doppiare contenuti in diverse lingue e generare narrazioni su misura per storie, audiolibri e podcast. Tuttavia, Microsoft richiede un “consenso esplicito” registrato prima che gli utenti possano utilizzare la propria voce sintetizzata per prevenire potenziali problemi legali.
L’introduzione di queste funzionalità suscita inevitabilmente questioni etiche, poiché le tecnologie di deepfake possono essere utilizzate in modo fraudolento, alimentando preoccupazioni riguardo all’abuso potenziale in contesti come la propaganda politica o la diffusione di informazioni false. Questi sviluppi richiamano l’attenzione sulla necessità di affrontare responsabilmente le implicazioni etiche e legali dell’uso di tecnologie avanzate come questa.
Alla luce di tutto questo, cosa ne pensate? Fatecelo sapere nei commenti